Sakana AI presenta DiffusionBlocks: entrenamiento modular de redes residuales
Por Redacción Automatización LatAm · 28 de mayo de 2026 · Fuente original: MarkTechPost
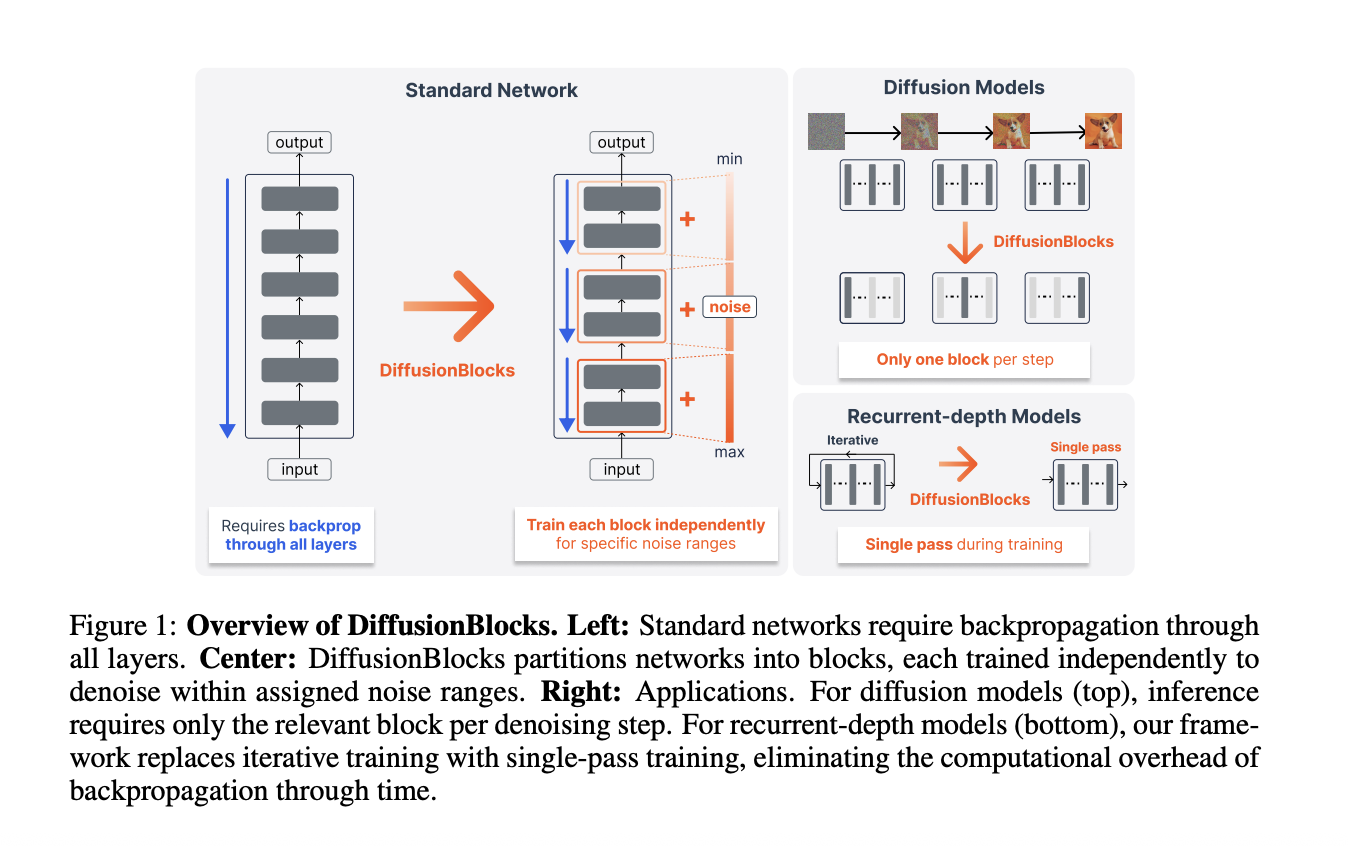
Sakana AI propone DiffusionBlocks, un framework que reinterpreta capas de redes residuales como pasos de desruidación por difusión inversa, permitiendo entrenar bloques de forma independiente y paralela. Esta aproximación promete acelerar el entrenamiento de modelos profundos.
Contexto del problema
El entrenamiento de redes neuronales residuales profundas requiere típicamente propagación hacia atrás secuencial a través de todas las capas, creando dependencias que impiden el paralelismo eficiente. Esta restricción genera cuellos de botella computacionales significativos, especialmente en centros de investigación y empresas de LatAm con recursos GPU limitados.
La propuesta de DiffusionBlocks
Sakana AI introduce una perspectiva innovadora: reinterpretar las actualizaciones de capas en redes residuales como pasos en un proceso de difusión inversa (desruidación). En este marco teórico, cada bloque residual se comporta como un módulo de desruidación independiente, similar a los utilizados en modelos generativos difusivos.
Esta reinterpretación fundamental permite que cada bloque se entrene de manera autónoma, sin necesidad de aguardar a que las capas precedentes completen su actualización. El resultado es un paralelismo a nivel de bloque que antes era imposible en arquitecturas tradicionales.
Detalles técnicos
El framework DiffusionBlocks convierte el problema de optimización secuencial en uno desacoplado. Cada bloque recibe ruido inherente desde las capas anteriores (conceptualmente equivalente al ruido en un paso de difusión) y aprende a refinarlo progresivamente. Las actualizaciones de pesos en un bloque no bloquean el entrenamiento de bloques posteriores, habilitando cómputo concurrente.
Esta arquitectura es compatible con redes residuales existentes (ResNet, DenseNet, y variantes modernas) sin requerir cambios profundos en la estructura base. El entrenamiento puede llevarse a cabo con estrategias de sincronización más laxas, reduciendo overhead de comunicación entre GPUs.
Implicaciones para Latinoamérica
Para la región, esta innovación tiene valor inmediato. Laboratorios de investigación, startups de IA y equipos de manufacturing automation que buscan entrenar modelos de visión computacional para aplicaciones industriales (inspección de calidad, detección de anomalías en líneas de producción) enfrentan restricciones presupuestarias. Un framework que reduzca tiempo de entrenamiento en 30-50% (cifras típicas observadas en métodos de desacoplamiento) permitiría que menos GPUs entrenen modelos comparables a soluciones propietarias.
Asimismo, en plantas manufactureras que adoptan IA para optimización de procesos, la capacidad de entrenar modelos localmente con hardware más modesto aumenta la autonomía operacional y reduce dependencias de servicios cloud externos, mejorando latencia y privacidad de datos sensibles.
El trabajo de Sakana AI también abre conversación sobre arquitecturas de entrenamiento más eficientes globalmente, un área donde instituciones de IA en LatAm pueden contribuir investigación adaptada a restricciones regionales de cómputo.
Este resumen es un análisis original. Para leer la noticia completa visita la fuente original: MarkTechPost →
Sigue leyendo
Kinference: plano de control para despliegue de LLMs en Kubernetes
Buoyant lanzó Kinference, una capa de orquestación de código abierto para modelos de lenguaje en Kubernetes que optimiza el enrutamiento de inferencias y reduce la latencia inicial de respuesta en un 95% según sus pruebas internas.
Fuente: MarkTechPost
Dataset sintético de NVIDIA capta dinámicas financieras de Japón
NVIDIA y Hugging Face presentan un conjunto de datos sintético que modela perfiles demográficos y comportamientos financieros específicos del mercado japonés, diseñado para entrenar modelos de IA más precisos en contextos locales y regulatorios.
Fuente: Hugging Face Blog
Un modelo IA único simula comportamiento de múltiples materiales
Investigadores del MIT desarrollaron WorldParticle, un sistema de IA capaz de predecir el comportamiento de diversos materiales —desde arena hasta proteínas— lo que potencia aplicaciones en robótica blanda, farmacéutica y manufactura.
Fuente: MIT News — AI
Google lanza modelo Elephant-Goldfish para agentes de código basados en especificaciones
Google presenta un plugin que obliga a agentes de IA a redactar especificaciones antes de generar código, aplicando cinco etapas de revisión sin contexto previo. Cambia el flujo de trabajo tradicional de desarrollo automatizado.
Fuente: MarkTechPost
Guía práctica: ejecutar Dory 4B de NVIDIA con llama.cpp
Análisis técnico de Dory 1.0 4B, el modelo de lenguaje comprimido de NVIDIA, con pasos para compilación, análisis de costos computacionales y optimización de memoria en entornos de inferencia local.
Fuente: MarkTechPost
Google abre Harness2: framework recursivo para optimizar agentes IA
Google Research lanzó Harness2, un framework de código abierto que reoptimiza el comportamiento de agentes de IA en tiempo de prueba sin actualizar pesos. Un ciclo de refinamiento mejoró el desempeño de GLM-5 en 11.5 puntos en WorkBuddy-Bench.
Fuente: MarkTechPost