MemPrivacy: Framework que protege datos en memorias en la nube sin perder utilidad
Por Redacción Automatización LatAm · 18 de mayo de 2026 · Fuente original: MarkTechPost
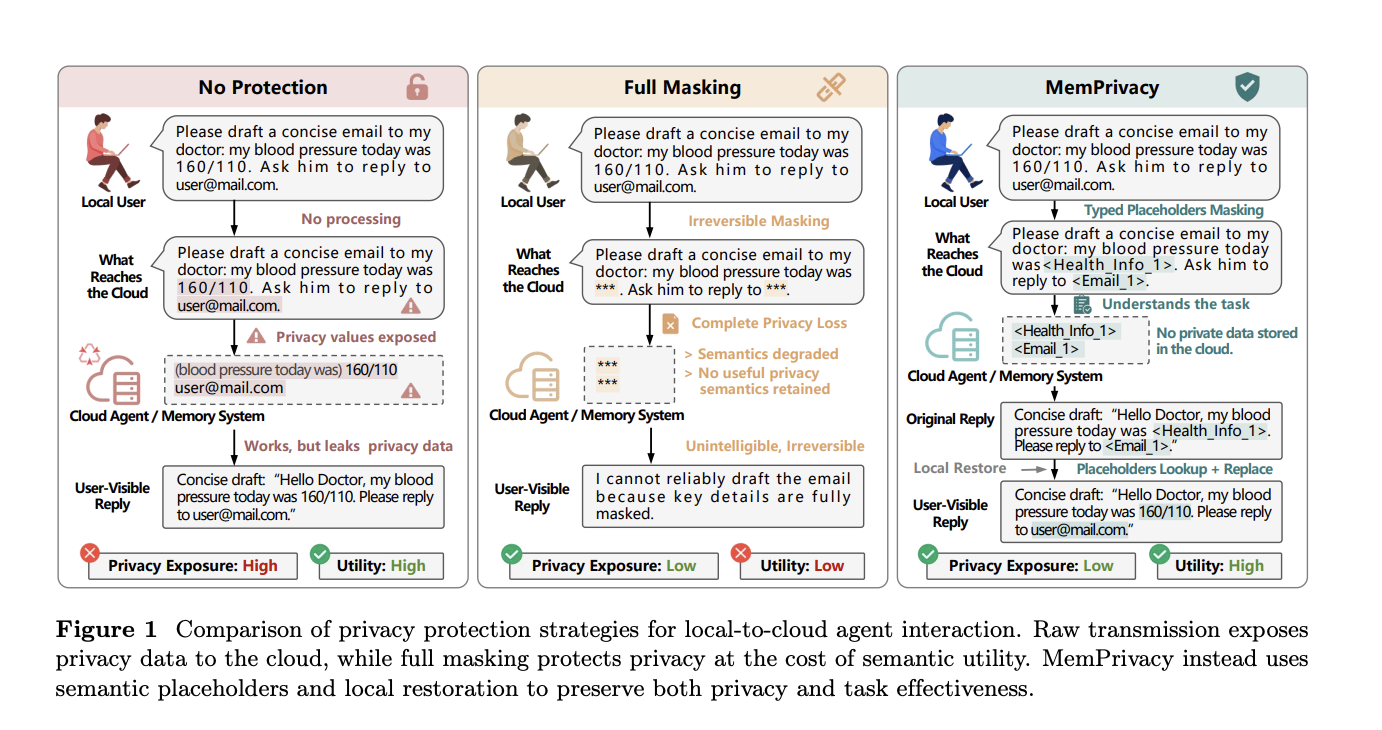
Un nuevo framework desarrollado por investigadores chinos combina procesamiento en edge con pseudonimización reversible local para proteger información sensible en sistemas de memoria distribuida, manteniendo la funcionalidad de agentes basados en LLM en producción.
El dilema de la memoria útil versus privacidad
La adopción acelerada de agentes inteligentes basados en modelos de lenguaje grande presenta un desafío fundamental para desarrolladores y empresas: los sistemas de memoria en la nube que hacen que estos agentes sean verdaderamente útiles requieren almacenar información detallada sobre usuarios, interacciones y contexto histórico. Cuanta mayor riqueza de datos históricos disponible, más potentes y personalizados son los sistemas. Sin embargo, esta misma capacidad expone datos privados a riesgos de fuga, acceso no autorizado y usos secundarios no previstos.
Introducción a MemPrivacy
Investigadores de MemTensor (con sede en Shanghai), HONOR Device y la Universidad de Tongji han presentado MemPrivacy, un framework arquitectónico que resuelve esta tensión mediante pseudonimización reversible ejecutada localmente en dispositivos edge. La solución separa físicamente la responsabilidad de mantener datos sensibles del almacenamiento centralizado en la nube, permitiendo que los agentes inteligentes aprovechen memorias distribuidas sin exponer identidades ni información personal de forma permanente.
Mecanismo técnico y operación
El corazón del framework es la pseudonimización reversible local: datos confidenciales como nombres, identificadores únicos, conversaciones personales o históricos de comportamiento se transforman en tokens opacos en el dispositivo del usuario antes de ser enviados a servidores en la nube. Estos tokens mantienen relaciones lógicas que permiten a los LLMs entender contexto y patrones sin acceso directo a los datos originales. Solo el dispositivo edge conserva las claves de reversión, lo que significa que incluso si un servidor en la nube es comprometido, los atacantes obtienen datos desanonimizados inútiles sin significado.
Esta arquitectura es particularmente relevante para sistemas que requieren memoria persistente y contextual: chatbots empresariales, asistentes virtuales personalizados, y plataformas de recomendación que necesitan recordar preferencias y patrones de un usuario sin exposición innecesaria.
Implicaciones para la industria en América Latina
En mercados como México, Brasil y Colombia, donde el cumplimiento regulatorio es cada vez más exigente, esta aproximación ofrece un camino para empresas que desean desplegar sistemas de IA en la nube sin infringir leyes de protección de datos. Operadores de telecomunicaciones, plataformas fintech y servicios de atención al cliente pueden mantener memoria útil de interacciones mientras garantizan que los datos permanecen bajo control del usuario.
El framework también reduce la carga de auditoría y cumplimiento: al mantener datos sensibles cifrados y localmente procesados, las organizaciones reducen su superficie de ataque y pueden demostrar más fácilmente conformidad con estándares como ISO 27001 y regulaciones locales.
Consideraciones técnicas futuras
Los desafíos restantes incluyen la latencia de reversión en escenarios de miles de usuarios concurrentes, la escalabilidad del almacenamiento de claves criptográficas en dispositivos heterogéneos, y la integración fluida con infraestructuras existentes de edge computing. El equipo continúa refinando el balance entre seguridad, rendimiento y usabilidad.
Este resumen es un análisis original. Para leer la noticia completa visita la fuente original: MarkTechPost →
Sigue leyendo
Diseño de chips con IA: la apuesta de Ricursive para resolver la crisis de cómputo
Una startup desarrolla sistemas de inteligencia artificial capaces de diseñar circuitos integrados de forma autónoma, aprendiendo de cada iteración para mejorar diseños posteriores y acelerar drásticamente los ciclos de desarrollo.
Fuente: TechCrunch AI
IA y minería: startup desafía dominio chino en materiales críticos
Empresa de optimización de minerales logra ritmo anual de $200M tras recaudar $25M. Busca expandir operaciones en EE.UU. y reducir dependencia de cadenas de suministro asiáticas.
Fuente: TechCrunch AI
Startup de IA multimodal alcanza valuación de $7.5B tras lanzamiento
TypeSafe, creadora del modelo Jev, logra valuación de $7.5B semanas después de su debut. La plataforma promete procesar datos no textuales con eficiencia superior y consumo de tokens significativamente reducido respecto a LLMs convencionales.
Fuente: TechCrunch AI
Poda de LLMs mediante optimización física: eliminación de bloques como problema de Ising
Investigadores aplican conceptos de física estadística para optimizar la poda de modelos de lenguaje grandes, tratando la eliminación de bloques como un problema de Ising. El enfoque promete reducir significativamente el tamaño de LLMs manteniendo capacidades críticas.
Fuente: Hugging Face Blog
Modelo de razonamiento Salesforce-Nvidia desafía a laboratorios IA
Salesforce Koa, basado en Nemotron de Nvidia, es un modelo optimizado para automatizar tareas de ventas, marketing y atención al cliente. Representa una tendencia de especialización que cuestiona el enfoque genérico de los laboratorios IA líderes.
Fuente: TechCrunch AI
Neocloud Lambda obtiene $1B en deuda para adquirir GPUs de IA
Una compañía de infraestructura asegura financiamiento por mil millones de dólares destinado a la compra de aceleradores Nvidia, que posteriormente arrienda a proveedores de nube. Este movimiento refleja la presión financiera creciente para sostener operaciones de centros de datos especializados en
Fuente: TechCrunch AI